日志与审计
控制面为运维人员提供两类证据链:用于 AISIX 网关流量的请求日志,以及用于控制面状态变更的审计日志。两者结合起来,可以帮助团队了解一次请求发生了什么,以及是谁修改了影响流量的资源。
使用请求日志排查具体的 AISIX 网关请求;使用审计日志排查配置、访问权限和其他控制面变更。
请求日志
请求日志基于 AISIX 网关遥测数据生成。它展示单个请求的结果,包括请求时间、状态、请求模型、调用方 API Key、延迟、Token 数量,以及可用时的尝试详情。延迟会从两个角度报告:调用方等待了多久,以及上游处理花费了多久。这样无需猜测即可判断慢请求的延迟来源。
展开一行会看到 AISIX 分配的 请求 ID;如果这次调用到达了会返回 ID 的服务提供方,旁边还会有一个 服务商请求 ID。二者含义不同:前者由 AISIX 通过 x-aisix-request-id 响应头返回给调用方,也是报障的调用方通常手上有的 ID;后者是上游服务提供方为这次调用给出的 ID,例如 OpenAI 的 chat.completion.id、Anthropic 的消息 id 或 Gemini 的 responseId;响应本身不带 ID 时,则是服务提供方的请求 ID 响应头,例如 Amazon Bedrock 的 x-amzn-requestid。服务提供方的控制台和技术支持渠道正是按它检索这次调用的。先用前者查到该请求,再从中读取后者,然后拿它去找服务提供方。
如果本次调用没有产生服务提供方请求 ID,该字段不会显示:包括响应由缓存命中返回、请求在 AISIX 到达服务提供方之前就被拒绝,以及服务提供方的响应既不带 ID 也不带请求 ID 响应头。失败的尝试、Token 计数、向量嵌入、音频和图像生成会记录响应头中的 ID。重试或故障转移的请求会按拿到响应的尝试各记录一个,因此请展开实际向调用方返回响应的那次尝试,或你要向服务提供方反馈的那次失败尝试。
一行的 Token 数:上游为该尝试上报了总数时取该总数,否则取提示词、补全、缓存创建和缓存读取计数之和。展开该行后,上报的总数显示为 Total tokens (reported by upstream)(上游报告的 Token 总数);没有上报总数的行不显示这一项。计数按上游上报的原样记录,因此某些行的推理 Token 可能多于补全 Token。详见按上报原样记录计数。
带有 estimated 标记的行包含一个或多个本地计算的 Token 数量,因为上游响应省略了这些值或将其报告为零。这种情况可能出现在 OpenAI 兼容中继、客户端在流式传输中途断开,以及上游返回部分响应后出错时。估算的 Token 数量会与服务提供方报告的数量一起计入支出和预算计算。排查用量或支出时,可以通过该标记区分估算值。有关支持的端点和估算行为,请参阅用量上报。
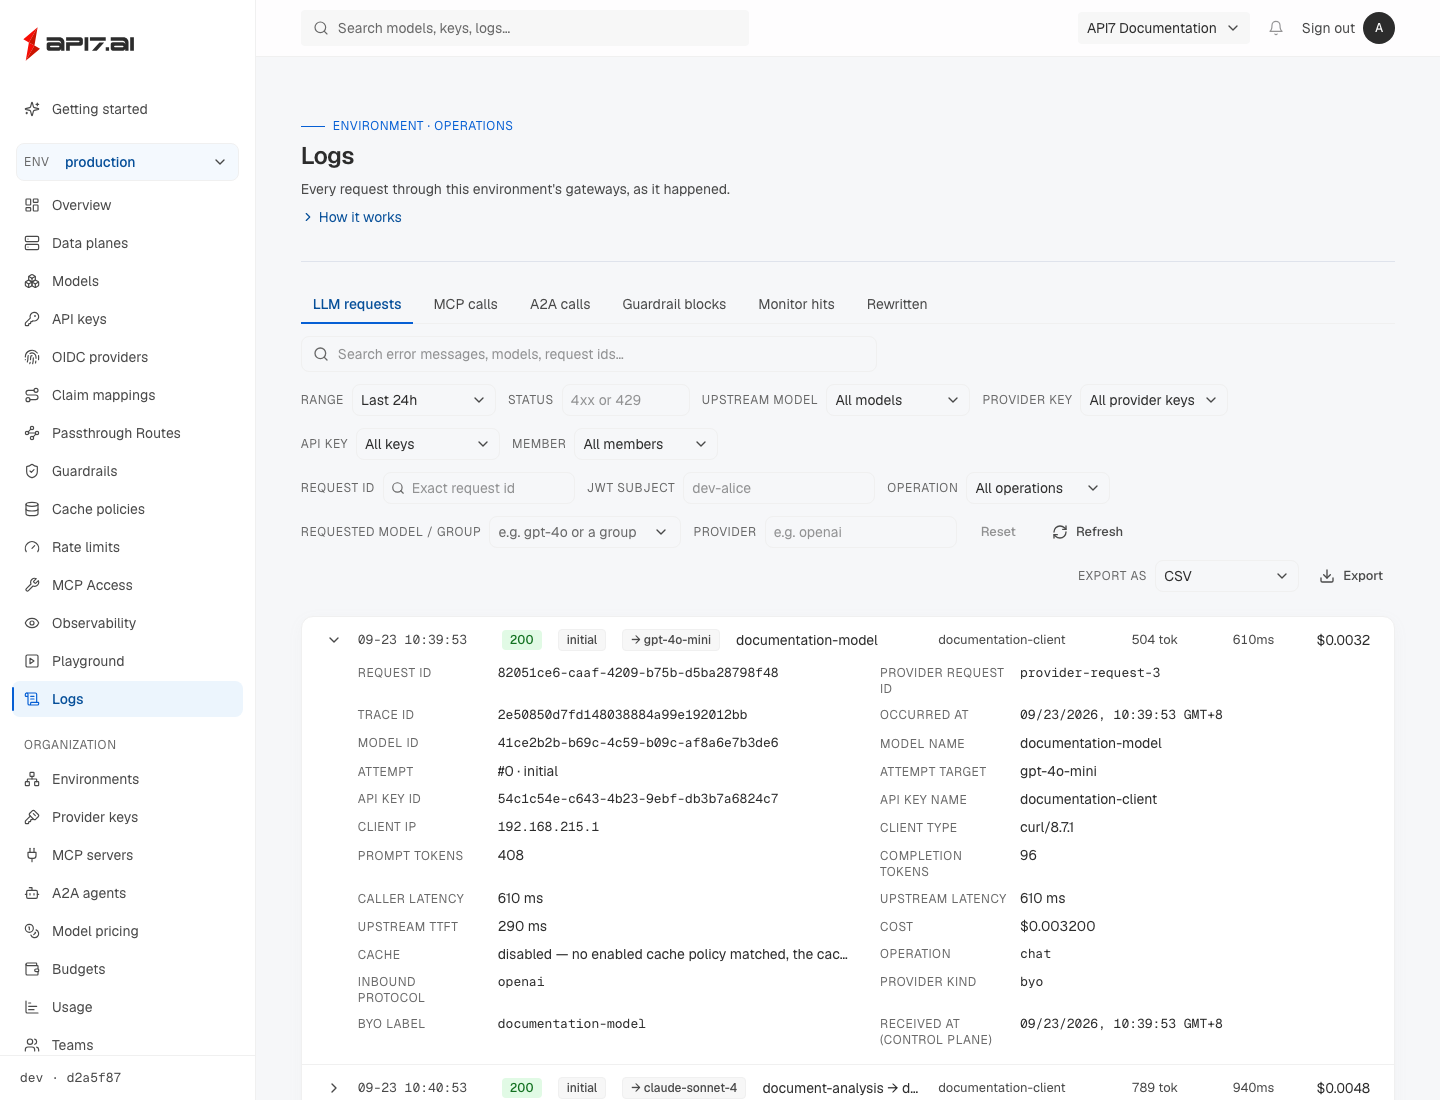
展开一行还会显示调用方 API Key 绑定的 团队,以及请求运行时归属的成本归属标签 标签。请求日志不提供标签筛选。要按标签拆分用量,请使用 成本分析,其中的 API Key 行可以打开本页面并按该 Key 筛选。
上游报告了其实际处理请求所用的服务档位时,展开的行会将其显示为 服务档位,使用服务提供方自己的词汇,例如 OpenAI 的 fast mode 为 priority。服务档位价格按这个值匹配。参见读取实际服务档位。
展开的行还会显示 平台成本,即该次尝试的用量按目标模型自身价格计算的成本;由阶梯费率决定成本时还会显示 价格阶梯。参见读取平台成本和价格档。计费明细 列出输入、缓存读取、输出等各计费项按其单价计算的金额以及低峰折扣,参见单次请求的计费明细。
数据面会批量刷新遥测数据,因此刚完成的请求可能需要几秒才会出现。
每行都会显示本地日期和时间,因此跨越多天的时间范围仍易于阅读。将鼠标悬停在时间戳上可查看包含时区的完整日期和时间。
当需要验证实时请求、检查上游错误、确认策略拒绝,或查看路由与故障转移如何解析请求时,请先查看请求日志。
解读延迟数据
请求日志行会显示调用方等待的时间。展开该行可以查看拆分后的测量值,因为单个数字无法判断慢请求是由服务提供方还是网关造成的:
| 字段 | 测量内容 | 范围 |
|---|---|---|
| 调用方延迟 | 从网关收到请求,到完成非流式响应或开始发送流式响应。 | 整个请求,包括每次重试和故障转移尝试。 |
| 上游延迟 | 实际处理该请求的尝试与服务提供方通信所花费的时间。 | 一次尝试。 |
| 上游首字延迟 | 该尝试等待服务提供方首个流式帧的时间,无论帧内容为何——包括 response.created、message_start 等元数据起始帧。仅适用于流式请求。 | 一次尝试。 |
讨论 SLO 时应引用调用方延迟;概览 页面中的 延迟 p50 / p99 卡片也使用该指标。
上游 TTFT 在流的首个帧到达时停止计时,而不是首个可见 Token。这与部署在 AISIX 前面的代理和网关的统计口径一致,因此该值可以与它们记录的数据直接对比。如果推理模型在思考期间不输出任何可见内容——例如 /v1/responses 上游会立即打开流、但不输出推理摘要——那么即使回答文本很晚才开始,TTFT 也会很小;这段思考等待计入上游延迟,而不是 TTFT。
对于流式响应,调用方延迟会在流开始时停止计时,而不是等到流结束。流的总持续时间会随模型生成的 Token 数量增加,无法有效反映用户体验;用户真正感知的是输出开始出现前的等待时间。
比较这些字段可以定位延迟。如果请求未重试,而调用方延迟远高于上游 TTFT,说明时间花在网关侧处理上。常见原因是执行脱敏的输出安全护栏:它必须缓冲完整响应流后才能释放内容。如果两者接近,则主要耗时来自服务提供方。对于发生重试或故障转移的请求,差值还包含先前的尝试,因此应先查看尝试记录。
延迟 p50 / p99 卡片只统计成功请求。被拒绝的请求通常很快,正是因为系统没有执行多少处理;如果将其计入,会拉低百分位数并掩盖实际的慢请求。对于上游中断或超时等情况,在 200 响应头发出后失败的流式响应会记录相应的失败状态,因此不算成功。输出安全护栏在 200 响应头发出后拒绝内容时,记录的状态仍为 200;分析此类记录时,还应检查 guardrail_blocked 和 error_class,不能只凭 200 判定成功。参见响应头发出后失败的流和用量日志记录了什么。
该卡片的百分位数是近似值。控制面从小时级用量汇总中计算它们:每个延迟值被归入对数分桶,每个桶比下一级宽约 10%,因此报告的 p50 或 p99 与同一批请求的精确百分位数相差约 5% 以内。概览 页面上的其他数字(如请求数和 Token 数)是同一汇总中的精确求和。
解读护栏命中
展开一条请求可以看到运行过的护栏以及每个护栏的处理结果。执行命中 列出 block 模式下护栏实际执行的动作,监控命中 列出 monitor 模式下护栏本应执行的动作:
| 区域 | 标签 | action | 含义 |
|---|---|---|---|
| 执行命中 | 已改写 | masked | 内容已脱敏,请求继续处理。 |
| 执行命中 | 已拦截 | blocked | 护栏策略拒绝了该内容。 |
| 执行命中 | 检查不可用 | blocked_unavailable | 护栏无法评估该内容,且其失败策略拒绝无法检查的内容。 |
| 执行命中 | 已拦截:超出缓冲上限 | blocked_buffer_exceeded | 被保留的流式响应超出输出缓冲上限,未经扫描即被拒绝。该命中指明 max_buffer_bytes 被触及的护栏。 |
| 执行命中 | 命中,未脱敏 | mask_unsupported | 脱敏规则在无法改写内容的路由(例如透传路由)上命中,内容不经修改地返回。 |
| 监控命中 | 本应拦截 | would_block | 护栏本应拒绝该内容。 |
| 监控命中 | 本应脱敏 | would_mask | 护栏本应对该内容脱敏。 |
| 监控命中 | 本应命中,无法脱敏 | would_mask_unsupported | 脱敏规则在无法改写内容的路由上命中,因此强制执行该规则同样不会脱敏任何内容。 |
绕过原因 在内容未经某个护栏判定就被放行时显示原始失败标记。除护栏类型自身的失败标记外,它还可能是 unscannable_body(AISIX 无法读取的内容),或 output_buffer_exceeded(在 on_buffer_exceeded: fail_open 下未经扫描放行的被保留流)。参见安全护栏行为。
区分策略拦截与故障拦截
护栏拦截 标签页列出所有被护栏拒绝的请求。其 拦截类型 筛选器区分两类拒绝:策略拦截,即护栏根据内容拒绝了请求;故障拦截,即没有护栏得出判定(例如其服务商不可用),且护栏配置为拒绝而非放行。筛选器默认显示 全部拦截,每条被拦截的记录都带有 策略拦截 或 故障拦截 标记。从该标签页发起的导出会应用同一筛选条件。
只有在有明确证据时,拒绝才会被归为故障拦截:至少一条执行命中的动作以 blocked_ 开头(例如 blocked_unavailable 或 blocked_buffer_exceeded),并且没有任何命中带有策略判定 blocked。其余拒绝都列在 策略拦截 下,其中包括无法区分类型的拒绝,例如记录时没有执行命中、或命中内容过大无法读取的拒绝,以及控制面升级到带有该筛选器的版本之前记录的所有拒绝。
语义护栏测到了什么
如果某个基于向量相似度的安全护栏筛查过这个请求,展开该请求还会看到 语义护栏相似度。每条记录会给出安全护栏名称和运行的钩子、它比对的是哪个示例列表、实测相似度与其比较的阈值、产生该分数的向量嵌入模型,以及最接近的那条示例在该列表中的行号。
放行的请求和被拒绝的请求都会记录,monitor 模式和 block 模式下也都会记录。这正是它对调优有价值的地方:监控命中只在安全护栏本应阻断时才出现,因此一个刚好差一点触发的行——拒绝阈值略高,或允许阈值略低——完全不会产生 监控命中,看上去与安全护栏根本没在运行毫无区别。而相似度分数两种情况下都会记录。
A2A 和 Rerank 请求都可以上报这些分数,但两者只运行输入钩子。A2A 不会解析模型或 MCP 服务器,因此只有环境、调用方 API Key 或团队绑定能应用到它。已通过身份认证并进入该端点分发处理的 Rerank 请求,会为成功结果及分发失败记录用量事件;上游未上报 Token 数时也会记录零 Token 用量事件,因此此类经过筛查的请求有记录可以承载这些分数。不要据此推断认证、解析等所有前置拒绝都会产生用量记录。
如果展开的请求没有分数,请先检查该行的其它部分,再判断安全护栏是否运行:
| 检查项 | 没有分数的原因 |
|---|---|
| 网关和安全护栏作用域 | 请求由旧版网关记录,或没有适用的语义安全护栏。 |
| 更早的安全护栏命中 | 优先级更高的安全护栏阻断请求后,护栏链停止。 |
| 尝试详情 | 重试、故障转移和合议请求只在终态行保留分数,而该行不一定列在最后。 |
| 端点和钩子位置 | 只作用于输出的安全护栏无法在只支持输入检查的端点上运行。 |
| 请求内容 | 使用默认 text_source: user_messages 时,只包含图片的请求没有可生成向量嵌入的文本。 |
| 流式结果 | 输出超过 max_buffer_bytes,并在语义筛查运行前被拒绝。 |
| 失败证据 | 向量嵌入调用在 AISIX 计算分数前失败。 |
向量嵌入失败会在同一行留下以下信号之一:
| 配置 | 请求结果 | 证据 |
|---|---|---|
| 阻断模式、失败关闭(默认) | 拒绝 | 执行命中 显示 检查不可用(blocked_unavailable)。 |
| 监控模式、失败关闭 | 放行 | 监控命中 显示 本应拦截。 |
| 任一模式、失败放行 | 在没有该安全护栏判定的情况下放行;护栏链其余部分继续运行 | 绕过原因 标识失败原因。 |
在把空白分数区域理解为没有发生任何事情前,请检查执行命中、监控命中和绕过原因。
不同向量嵌入模型的分数不可互相比较,因此每个分数旁边都会显示对应的模型。被筛查的文本和示例文本都不会被记录——示例只通过 top_example_index 来标识,它是该方向列表中从 0 开始的序号,而控制台会把它渲染成从 1 开始的行号。如何把这些数值转化为一个阈值,参见校准语义筛查安全护栏。
按请求类型筛选
每一行都会携带该请求要求网关做的事情——对话补全、图片生成、视频提交、工具调用——操作类型 筛选器可以把日志收窄到其中一类。行上没有别的字段能回答这个问题:所有 OpenAI 兼容端点上报的入站协议相同,因此文本对话和图片生成看起来一样;模型名称也不是替代品,同一个模型可以服务多个端点,而调用方是通过别名和模型组来寻址模型的。
除四个对话类取值(chat、messages、responses、completions,常见情况)外,每一行都会标出操作类型;展开行即可看到取值本身。网关升级之前记录的请求不携带操作类型:它们既不会被标出,也不会被该筛选器选中。该筛选器在所有标签页上都生效——MCP、A2A 和透传流量本身也是操作类型——并且切换标签页后依然保持。它是在标签页之内收窄而不是覆盖标签页,因此一个本就为空的组合(比如在 LLM 标签页上选 mcp)会返回空列表,而不是列出 MCP 流量。
取值清单及各自的含义参见区分请求类型,那里同时说明了同一个字段如何到达外部导出器。
在读计数之前有两点需要了解。操作类型描述的是请求,因此失败或被策略拒绝的行携带的取值与成功请求相同——这正是你能看出拒绝发生在哪个端点的原因。另外,发生重试或故障转移的请求每次尝试产生一行,因此按行计数得到的是尝试数而不是请求数。如果要每个请求只看一行,参见每个请求只看最后一条。
每个请求只看最后一条
在筛选栏「重置」左边勾选每个请求只看最后一条,列表会收窄为每个请求一行。它默认不勾选,因为失败的尝试往往正是你要找的内容。它对列表和导出都生效,切换标签页时保留,「重置」会清除它。
在 Admin API 中,向 GET /environments/{env_id}/usage_events 或 GET /environments/{env_id}/usage_events/export 传 final_attempt_only=true。该参数为布尔值,默认 false,其他取值返回 400。列表的 total、导出的 X-Export-Total 响应头,以及 JSON 导出尾部的 total 和 exported 都按返回的行计数,并受总数与翻页和导出请求中所述的限制。
读取结果时请注意以下几点:
- 保留的这一行是该请求的最后一条记录,可能是给出答复的回退、最后一个失败、安全护栏拒绝,或合议的评审模型行。
- 被过滤行的 Token 和费用不会汇总到保留行,不能用过滤结果来计算花费。
- 来自 1.8.0 及更早版本网关的行和升级前的行没有标记,始终返回。这样记录的回退请求在开启过滤后仍显示全部尝试。
- 网关丢弃了某个请求的最后一行时,该请求不会出现在过滤结果中。
- 这是查询过滤,不是访问控制。能读取该数据的人不传参数仍能看到全部尝试,保留的行也仍带
attempt_kind、attempt_index和attempt_model。如果要向不应看到这些尝试的人展示数据,请由你自己的服务控制。
搜索请求
筛选器上方的搜索框会在请求的所有文本字段中查找输入内容,且不区分大小写。搜索范围包括错误消息和错误类别、请求模型和解析后的模型名称、服务提供方及服务提供方密钥标签,以及客户端 User-Agent、源 IP、完成原因、请求 ID 和服务提供方请求 ID——因此服务提供方技术支持渠道提供的 ID 也能在这里找到对应的请求。当你只掌握客户端报告的部分错误内容,却不知道它位于哪个字段时,可以使用搜索功能。
搜索会与筛选器组合,而不是替代筛选器。例如,搜索 rate limit 并同时选择 5xx 状态筛选器,只会返回文本中提到限流的服务端错误。已知请求 ID、模型、服务提供方密钥或调用方 API Key 时,专用筛选器仍是更精确的方式。
在 请求模型/模型组 筛选器中,直接输入会对别名进行不区分大小写的模糊(子串)匹配;从候选项选择模型或模型组时,则会对完整别名进行区分大小写的精确匹配。导出会沿用请求列表当前生效的输入或选择匹配方式。
总数与翻页
列表会先加载行,计数完成后再显示总数。计数到 10,000 条匹配行为止,更多的结果显示为 10,000+。如果计数未能及时完成,页脚会显示总数未知;只要当前页已满,下一页 仍然可用。
只能翻阅前 10,000 条匹配行,到达该深度时页面会显示提示。要查看更早的行,请缩小时间范围。如果加载行耗时过长,页面会显示错误,提示你缩小时间范围或添加筛选条件。
状态 筛选器提供建议项 失败(4xx/5xx),对应的值为 400-599。它只按状态码筛选,查不到状态为 200 的 MCP 和 A2A 失败行,这类行在列表中标为 工具错误 或 智能体错误。要查找这类行,请用搜索框搜索 error_class 的值,例如 tool_error。各取值参见工具调用失败和 Agent 返回的 JSON-RPC 错误。该输入框仍可自由输入其他值:状态族(如 4xx)、具体状态码(如 429)或区间(如 500-599)。
GET /environments/{env_id}/usage_events 遵循相同的限制:
total最多计数到 10,000 行,并与total_is_capped一起返回;匹配行数超过上限时,total_is_capped为true。- 计数的时限为 5 秒。未能完成时仍会返回行,但
total和total_is_capped都不会出现。 - 偏移量
(page - 1) * limit达到 10,000 时返回400INVALID_REQUEST。请改为缩小时间范围。 - 查询行的时限为 30 秒。超时后返回
503QUERY_TIMEOUT。请缩小时间范围或添加筛选条件。
如果现有 AISIX 企业版集成必须翻阅前 10,000 行之后的数据,可以发送 legacy_paging=true。AISIX Cloud 会以 400 INVALID_REQUEST 拒绝此参数,控制台也不使用它。
兼容分页会移除偏移量边界和应用层时间预算。它返回精确且不设上限的 total,以及 total_is_capped: false;如果设置了 include_total=false,则省略计数。每个包含总数的页面都会重新执行完整计数,较深的偏移量可能在跳过前面各行时一直占用数据库连接。遍历期间新到达的行会使后续页面发生位移。如果查询失败,包括数据库强制超时,调用会返回 500 INTERNAL。新的自动化应保留默认的有界行为,并尽可能缩小时间范围。
total 统计的是尝试而不是请求,并且有上限,因此不要把它当作流量数据。要获取时间窗内的请求数,请读取 GET /environments/{env_id}/usage_summary。
导出请求
导出 会下载符合当前筛选条件和搜索内容的所有请求,而不仅是屏幕上的当前页。选择 CSV 可在电子表格中审查,选择 JSON 可供下游流水线使用;JSON 会返回与控制面 API 相同的字段,并包装在包含 data 数组和 total 总数的对象中。
两种格式都包含请求时间、请求 ID、尝试详情、状态和错误文本,还包括操作类型、请求模型和解析后的模型名称、调用方 API Key 名称、Token 数量、延迟及成本。upstream_cost、price_tier_index 和 price_tier_max_input_tokens 也是 CSV 列,null 为空单元格;参见读取平台成本和价格档。其中 total_tokens 是上游上报的总数;上游未上报时,在 JSON 中为 null,在 CSV 中为空单元格。调用方延迟和上游延迟会分别写入独立的列。CSV 文件采用带字节顺序标记的 UTF-8 编码,因此电子表格应用可以正确读取非 ASCII 错误消息。安全护栏相关的证据也会随行导出:guardrail_scores 记录各语义安全护栏实测的相似度,在 CSV 中是一列,在 JSON 中是一个数组。每次安全护栏拒绝的 guardrail_blocked 都为 true,而 guardrail_blocked_fail_closed 只在拒绝被归为故障拦截时为 true,归类规则见区分策略拦截与故障拦截。控制面升级之前记录的行在该列中为 false。CSV 还包含 team_id、tags 和 service_tier 列。tags 以 JSON 对象形式保存标签,请求没有标签时为空。service_tier 是上游实际处理请求的档位,上游未报告时为空。在 JSON 中,只有请求带有 team_id、tags 和 service_tier 时,行中才会包含这些字段。cost_components 列以 JSON 数组形式保存请求的成本明细,off_peak_discount 表示非高峰折扣减免的金额。对于成本明细功能推出之前记录的行,这两列在 CSV 中为空,在 JSON 中为 null。
时间戳默认使用 UTC,采用带 Z 后缀的 RFC 3339 格式,例如 2026-09-12T04:03:01Z。从控制台导出时,occurred_at 和 received_at 会改用浏览器自身的时区渲染,因此下载的文件与页面显示的是同一个墙上时间。通过控制面 API 调用时,可以用可选的 timezone 查询参数指定,取值为 IANA 时区名称(如 Asia/Seoul):此时每个时间戳都会带上该时区的数字偏移量(2026-09-12T13:03:01+09:00);timezone=UTC 仍然输出 Z 形式,而空值、Local 或无法识别的名称会返回 400。两种格式的行为一致;不传该参数时文件与以前逐字节相同,因此现有自动化流程不受影响。
成本使用组织币种。CSV 中的成本列名为 cost,最后一列 currency 在每一行给出该币种。JSON 的每一行以 cost 携带成本,并以已废弃的名字 cost_usd 再携带一次,数据行之后的结尾部分给出 currency。两种格式中它都是组织当前的币种,因此切换币种之前记录的成本会不经换算地按该币种报告。1.9.0 及更早版本的控制面把该 CSV 列命名为 cost_usd,也不导出 currency。该列的位置不变,因此按位置读取列的脚本不受影响。
一次最多导出 50,000 个请求,并按时间从新到旧排列。当匹配结果超过该数量时,控制面会导出最新的 50,000 个请求,并将 X-Export-Truncated 设为 true。请缩小时间范围或筛选条件,以导出其余请求。
控制面只计数到 50,001,这足以判断文件是否被截断。匹配结果更多时,X-Export-Total 和 JSON 的 total 报告的是 50,001,而不是完整的匹配总数。
文件开始传输前的计数最长约需 35 秒,每批读取的时限为 30 秒。计数超时时,导出返回 503 QUERY_TIMEOUT,不生成文件,请缩小时间范围或添加筛选条件。文件开始传输后发生的失败会切断连接,因此下载会失败,而不会留下一个看似完整的短文件。
审计日志
审计日志记录控制面状态变更,用于合规审查和运维调查。它会显示谁创建、更新或删除了环境、模型、API Key、服务提供方密钥、预算、策略和 Admin Token 等资源。
如果配置更新后流量行为发生变化,请使用审计日志。请求日志可以展示请求结果,审计日志则可以确认该结果出现前是否修改了控制面资源。
审计访问受组织权限控制。所有者和管理员可以访问;角色与自定义角色也支持向自定义角色授予 read / audit 权限,例如只读审计角色 auditor。请按部署版本和该成员的实际授权核验审计入口,不应将审计读取权限一概限定为这两个内置角色。
条目按时间从新到旧排列,记录列表底部会显示当前筛选条件匹配的条目总数。页码对应完整的已筛选集合,而不是当前已经加载的内容,因此可以从已知位置继续审查。
筛选和搜索审计记录
记录列表上方的筛选器可以按资源类型、操作者和时间缩小范围。资源类型列表只提供该组织实际记录过的类型。时间范围提供预设值和 自定义范围;后者接受明确的开始与结束时间,可将审查锁定到事件发生的精确时间窗口。
搜索框会在条目的可读字段中查找输入文本,且不区分大小写。搜索范围包括变更前后的状态(资源显示名称位于其中)、资源类型和标识符、Action、Actor 标识符、客户端 IP 地址和 User-Agent。如果工单只给出了资源名称,却没有说明是哪次变更影响了它,可以使用搜索功能。
搜索会与筛选器组合,而不是替代筛选器。例如,搜索模型名称并同时选择一个操作者,只会返回该人员涉及该模型的变更。已知资源类型或操作者时,专用筛选器仍是更精确的方式。
导出审计记录
导出 会下载符合当前筛选条件和搜索内容的所有条目,而不仅是屏幕上的当前页。选择 CSV 可在电子表格中审查,选择 JSON 可供下游流水线或证据归档使用。JSON 会返回与控制面 API 相同的字段,并包装在包含 data 数组和 total 总数的对象中。
两种格式都包含条目时间和标识符、Action、资源类型和标识符、客户端 IP 地址和 User-Agent,以及完整的变更前后状态。它们还会同时包含 Actor 的电子邮件地址和 Actor 标识符,使没有控制台访问权限的审查人员也能理解导出文件。CSV 文件采用带字节顺序标记的 UTF-8 编码,因此电子表格应用可以正确读取非 ASCII 资源名称。
在 AISIX 企业版中,如果控制面位于 Ingress 或负载均衡器之后,在你把该代理列入 api.trustedProxies(Docker Compose 中为 AISIX_TRUSTED_PROXIES)之前,客户端 IP 地址都是代理的地址。参见反向代理。
created_at 列按浏览器报告的时区渲染,采用带该时区数字偏移量的 RFC 3339 格式(例如 2026-09-12T13:03:01+09:00),因此导出的审计记录与页面显示的是同一个墙上时间。如果浏览器没有给出时区,该列仍保持带 Z 后缀的 UTC 形式。
一次最多导出 50,000 个条目,并按时间从新到旧排列。当匹配结果超过该数量时,控制面会导出最新的 50,000 个条目,并报告完整的匹配总数。请缩小时间范围或筛选条件,以导出其余条目。
文件开始传输后发生的失败会切断连接,因此下载会失败,而不会留下一个看似完整的短文件。
审计记录及其导出使用经过身份认证的控制台审计路由。该路由不属于 AISIX Cloud Admin API 参考所记录的 Admin Token 自动化工作流。
调查请求结果
使用属于同一网关环境的调用方 API Key 和模型别名,通过 AISIX 网关端点发送请求。
请求完成后,在请求日志中检查匹配的请求时间、状态、请求模型和调用方 API Key。如果请求使用了路由或故障转移,请在可用时查看解析后的模型或尝试详情。
上游身份认证、配额或服务提供方侧错误仍可以证明 AISIX 网关路径正常。此时,请求已经到达 AISIX;AISIX 选择了已配置的模型和服务提供方密钥,随后上游服务提供方返回错误。
除非日志显示错误的模型、服务提供方密钥或环境,否则不要把服务提供方错误视为资源投射失败。
调查策略拒绝
通过控制面配置的策略可以在网关调用上游服务提供方之前拒绝流量。对于预算,由控制面计入支出并把预算标记为已用尽,网关执行它收到的预算,控制面不可达期间也是如此。预算硬性限制会返回预算相关错误。限流策略由网关执行,并返回限流错误。安全护栏同样由网关执行,可根据护栏钩子在服务提供方调用前或调用后拒绝不安全内容。
请求被拒绝时,请先确认响应来自 AISIX 还是上游服务提供方,再通过请求日志检查状态和请求身份。
对于预算拒绝,请把返回的预算范围与 预算 视图进行比较。对于限流拒绝,请检查与请求匹配的调用方 API Key、模型、团队或成员策略。对于安全护栏拒绝,请检查安全护栏范围,以及触发它的模型或调用方身份。
流量未出现在请求日志中
并非每个请求都会产生记录。对于模型路由,AISIX 来不及归因就拒绝的请求——未认证的调用、认证失败、正文无法解析、正文超过大小限制——只会进入网关的指标,以及在会写访问日志的场景下进入访问日志,不会进入请求日志。透传路由是例外:认证失败也会产生用量事件,但不携带 API Key ID;网关在认证完成后才读取正文,因此正文超限也会产生用量事件。健康检查与发现类路由在任何结果下都不产生请求日志记录,其中 /livez 和 /readyz 也不写访问日志。各类结果的完整清单,以及每类结果携带的状态码和 error_class,请参阅用量日志记录了什么。
如果本应产生记录的请求在请求日志中找不到,请先检查请求路径。请求日志只包含选中环境的 AISIX 网关流量,因此发送到其他网关端点或其他环境的请求会显示在对应位置。
如果请求路径正确,请检查 AISIX 网关是否有较新的心跳,并确认它可以访问控制面遥测端点。
其他控制面信号也可以帮助缩小原因:
| 信号 | 显示内容 |
|---|---|
| 数据面心跳 | AISIX 网关是否已连接控制面,并且是否从预期环境上报。 |
| 用量 | 控制面是否收到了用于汇总用量和预算工作流的 AISIX 网关遥测数据。 |
| 可观测性导出器健康状态 | 网关是否已应用导出器配置,并是否正在上报外部遥测目的地的投递状态。 |
外部导出器
请求日志展示控制面对 AISIX 网关遥测数据的视图。可观测性导出器从环境的 可观测性 视图配置,并将用量事件从 AISIX 网关发送到你控制的目的地。
当需要将请求遥测发送到外部链路追踪、日志、存储或核算系统时,请使用导出器。导出器由 AISIX 网关直接向目标目的地投递数据。即使外部目的地存在凭证、网络或接收路径问题,请求日志仍然可能存在。
数据保留
控制面按每个组织各自的保留窗口保留用量数据,其中包括 日志 和 用量 视图背后的数据。默认保留 30 天,控制面每天移除更早的记录。
组织所有者和管理员可以在 设置 的 数据 标签页中,通过 用量日志保留期 把保留窗口设置为 1 到 365 天之间的任意值。更长的窗口能保留更多历史用于排查和报表,更短的窗口则减少存储的数据量。修改只对之后生效,并在下一次每日清理时起作用。在 日志 中可选的时间范围随该窗口变化。
由于保留策略,较早的流量最终会从请求日志和用量视图中消失。移除这些记录不会减少预算已计入的支出。如需更长的历史记录,请在记录被移除前,通过可观测性导出器把用量事件发送到外部存储。
审计事件默认保留 730 天,之后由每日清理移除。该保留期是部署级设置,而非组织设置:AISIX 企业版运维人员通过 audit.retention_days 设置,0 表示永久保留审计事件。参见AISIX 企业版配置。如需保留超出保留期的审计记录,请在它们被移除前导出审计记录。
下一步
有关支持的自动化操作,请使用 AISIX 企业版与 AISIX Cloud 的 Admin API。如需将网关遥测数据投递到自有系统,请继续阅读可观测性导出器。